AI 공학 평가 최고 50.6%…완료율 아닌 산출물 점수
구글 클라우드 연구진은 모델 14개와 실행 환경 7개를 85개 과제로 비교했다. 클로드 오퍼스 5.5와 클로드 코드 조합이 세 차례 실행 평균에서 가장 높은 점수를 받았다.
Artificial Analysis의 평가에서 GPT-6 Astra가 5개 모델 가운데 1위에 올랐다. 모델 대부분은 과제 하나에 약 30분을 썼고, 사람은 평균 20초가 걸렸다.
리눅스재단 조사에서 대형 프로젝트 유지관리자의 64%는 AI 지원 기여로 검토 시간이 늘었다고 답했다. 깃허브는 9월 풀리퀘스트 중 에이전트가 첫 초안을 시작한 비중이 40%를 넘었다고 집계했다.
맥 앱과 웹의 Pro·Max 구독자는 음성 대화로 여러 Computer 세션과 Projects를 관리할 수 있다.
미국에서는 여러 차례 질문을 주고받는 AI 모드에도 광고를 도입한다. 알파벳의 3분기 전체 매출은 전년 동기보다 25% 늘었다.
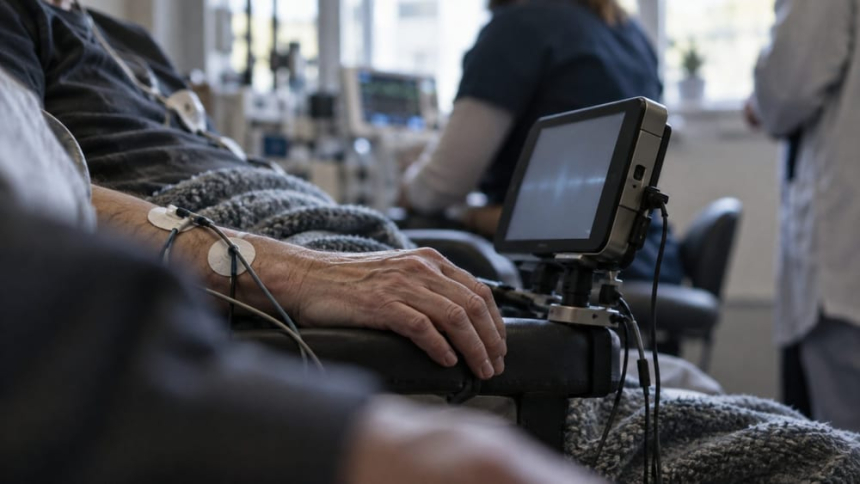
뉴럴링크는 근위축성 측삭경화증 참가자 한 명의 초기 데이터에서 분당 75단어와 단어 오류율 5.8%를 제시했다. 오류율 측정에는 12만5000단어 어휘가 적용됐다.
알파벳은 AI 투자가 상업성 질의를 포함한 검색 증가를 이끌었다고 밝혔다. ‘검색·기타’ 매출은 전년 동기보다 12% 늘었지만 검색 단독 매출과 AI 기능별 기여도는 따로 제시되지 않았다.
순다르 피차이는 실적 발표에서 미국 정부가 모델을 시험 중이라고 밝혔다. 구글은 일부 사이버 방어 담당자에게 먼저 제공한 뒤 접근 범위를 넓힐 계획이다.
구글 광고주들은 2025년 4분기 AI Max와 Performance Max에서 제미나이 문안 맞춤화 기능으로 거의 7000만개의 소재를 만들었다. 생성량은 광고 성과와 구분되는 지표다.
코어위브는 28일 전날 종가보다 1.49% 높은 가격에 거래를 시작했다. 6월 말 부채 원금 상환표 총액은 355억5100만달러(약 47조7300억원)였다.